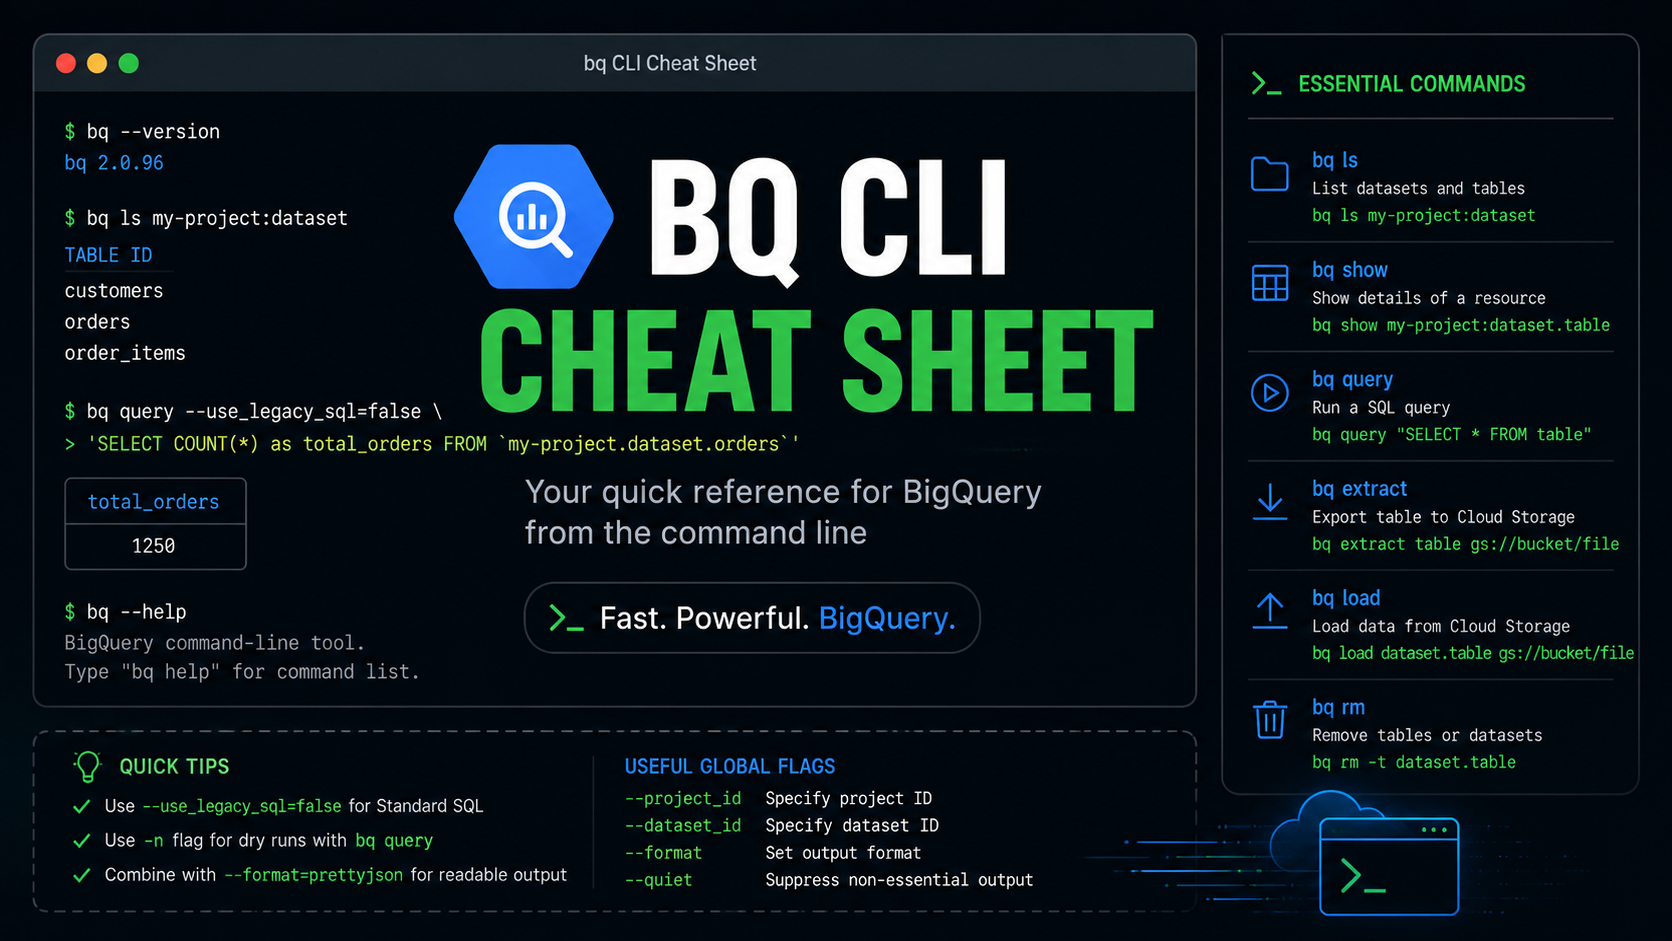
BigQuery CLI (bq) Cheatsheet
The bq command-line tool lets you interact with Google Cloud BigQuery from your terminal. Here are the most common and advanced commands, options, and patterns.
Authentication
1
2
| gcloud auth login
gcloud config set project [PROJECT_ID]
|
Table & Dataset Management
List Datasets
List Tables in a Dataset
Show Table Schema and Metadata
1
2
| bq show [DATASET].[TABLE]
bq show --format=prettyjson [DATASET].[TABLE]
|
Create Dataset
Delete Dataset
Create Table
1
2
| bq mk --table [DATASET].[TABLE] [SCHEMA]
# Example schema: name:STRING, age:INTEGER
|
Delete Table
1
| bq rm -t [DATASET].[TABLE]
|
Update Table Schema
1
| bq update --table [DATASET].[TABLE] [NEW_SCHEMA]
|
Querying Data
Run a Query (Standard SQL)
1
| bq query --use_legacy_sql=false 'SELECT * FROM [DATASET].[TABLE] LIMIT 10'
|
Run Query from File
1
| bq query --use_legacy_sql=false < query.sql
|
Save Query Results to Table
1
| bq query --destination_table=[DATASET].[TABLE_DEST] --use_legacy_sql=false 'SELECT ...'
|
Dry Run a Query (for Cost Estimation)
1
| bq query --dry_run --use_legacy_sql=false 'SELECT COUNT(*) FROM [DATASET].[TABLE]'
|
Query with Parameterized Values
1
| bq query --parameter='name::STRING:John' --use_legacy_sql=false 'SELECT * FROM [DATASET].[TABLE] WHERE name=@name'
|
Data Import/Export
Load Data from CSV/JSON/Parquet/Avro
1
2
3
4
5
6
| bq load --source_format=CSV [DATASET].[TABLE] gs://bucket/file.csv [SCHEMA]
# Schema format: field1:TYPE,field2:TYPE,field3:TYPE
# Example: name:STRING,age:INTEGER,salary:FLOAT,active:BOOLEAN
bq load --source_format=NEWLINE_DELIMITED_JSON [DATASET].[TABLE] gs://bucket/file.json [SCHEMA]
bq load --source_format=PARQUET [DATASET].[TABLE] gs://bucket/file.parquet
bq load --source_format=AVRO [DATASET].[TABLE] gs://bucket/file.avro
|
Advanced Loading Options
1
| bq load --replace --skip_leading_rows=1 --field_delimiter="," [DATASET].[TABLE] gs://bucket/file.csv [SCHEMA]
|
Export Table to GCS
1
2
3
4
| bq extract [DATASET].[TABLE] gs://bucket/file.csv
bq extract --destination_format=CSV [DATASET].[TABLE] gs://bucket/file.csv
bq extract --destination_format=PARQUET [DATASET].[TABLE] gs://bucket/file.parquet
bq extract --compression=GZIP [DATASET].[TABLE] gs://bucket/file.csv.gz
|
1
| bq extract [DATASET].[TABLE$YYYYMMDD] gs://bucket/partitioned.csv
|
Jobs & Monitoring
Show Job Status
List Recent Jobs
Cancel a Running Job
Advanced Table Operations
Copy Table
1
| bq cp [DATASET].[TABLE_SRC] [DATASET].[TABLE_DEST]
|
Table Snapshot
1
| bq mk --snapshot [DATASET].[TABLE]@[SNAPSHOT_TIME] [DATASET].[SNAPSHOT_TABLE]
|
Restore Table from Snapshot
1
| bq cp [DATASET].[SNAPSHOT_TABLE] [DATASET].[RESTORED_TABLE]
|
Partitioned Tables
1
| bq mk --table --time_partitioning_type=DAY [DATASET].[TABLE] [SCHEMA]
|
Miscellaneous
Display Help for Any Command
Show User Quota and Project Info
1
| bq show --format=prettyjson --project_id=[PROJECT_ID]
|
Useful Flags
--location=US : Specify location--max_rows=100 : Limit query results--format=json|csv|pretty : Output format--replace : Overwrite destination table/file--compression=GZIP|NONE : Compression for extract
Example Workflow
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
| # List all datasets
bq ls
# List tables in dataset
bq ls my_dataset
# Show table schema
bq show my_dataset.my_table
# Query table
bq query --use_legacy_sql=false 'SELECT COUNT(*) FROM my_dataset.my_table'
# Load CSV data
bq load --source_format=CSV my_dataset.my_table gs://my_bucket/my_file.csv name:STRING,age:INTEGER
# Extract table in Parquet format
bq extract --destination_format=PARQUET my_dataset.my_table gs://my_bucket/my_file.parquet
|
References